Airbnb Inside-Out AI:先加速内部开发,再把同一套能力交给客人
Airbnb CTO 用 AI 改真实工作:产品设计工程对着原型和代码协作,客服约一半工单自动结案,Everest 让接机从数月缩到约 6 周。
结论
Latent Space 访谈 Airbnb CTO Ahmad Al-Dahle(2026 年 1 月从 Meta 生成式 AI 负责人和 Llama 开源项目转任):Airbnb 要做成「AI 原生」公司,走的是 inside-out(由内向外)——先用 AI 改团队怎么做产品,再把同一套能力铺到客人体验上。他对上的效率数字是:约 60% 代码由 AI 撰写,功能与改进同比多了近 80%,人均 PR 吞吐约 1.6 倍;客人侧,客服工单大约一半由 AI 独立结案。
要点
-
省时间的第一刀是砍掉文档交接,不是多装一个聊天窗口。 过去是需求文档 → Figma → 工程实现 → 测试,产品、设计、工程来回等。现在三方直接对着原型和代码干活。Al-Dahle 把用来对齐的中间产物叫 artifact(工件):以前是 PRD,现在是能跑的代码。拆掉这段等待,才是传统软件公司最大的节省。
-
客服是第一个对外场景,也是他们说「最难上线」的场景。 约一半工单纯靠 AI 结案(公司 Q2 披露接近 45%)。上线前先造一批合成数据(用模型生成的模拟工单)把 Agent 测透。安全类等高利害票刻意不交给 Agent——解决 50%,是因为他们清楚哪些还不能自动解决。
-
Everest 把第一次踩的坑变成下一次的上下文。 这是内部「组织上下文图谱」:用大模型、向量(embedding,把文字编成可检索的数字)和检索,把代码与项目经验串起来。杂货配送和接机都是对接外部合作方 API 的同类服务;杂货做了 8–9 个月,经验进 Everest 后,接机大约 6 周。通才工程师也能跨进原先很专的代码区。
-
按「缺陷有多贵、延迟有多敏感」选模型,而不是全公司一把旗舰刀。 Airbnb 自称多模型公司,生产里至少 10 个针对业务适配过的模型,混用前沿模型和开源模型。编码容得下慢,但漏测很贵,所以用最强的编码模型;搜索量大、对延迟敏感,用又小又快、按生产搜索词评测过的模型,窄场景里有时比前沿模型更好。
-
下一刀是值班自动化,但人还是要讲得清 AI 写了什么。 内部助手 AirChat 带着公司上下文。已有团队在监控告警(如 Grafana 阈值)触发后,拉起容器里的 Agent 做一线值班:先分诊,人审 Agent 提的 PR,误报可以由 Agent 关掉。Al-Dahle 同时要求:即使 PR 是 AI 写的,工程师也必须能讲清自己交付了什么。
怎么做
面向正在把 AI 推进真实工作流的 junior 和 Tech Lead:不必复制 Everest 这个名字,按同一条因果链做。
-
先改协作物,再谈「AI 写了多少代码」。 把评审对象从长文档改成可点的原型和 diff。产品、设计、工程围着同一份能跑的东西改,交接时间才会掉下来。
-
高利害流程:先合成评测,再划自动结案范围。 客服、退款、安全,先用模拟工单测 Agent,只放开你敢承担后果的类型。写清楚「这批票永远转人」。
-
第一次集成的经验要可检索。 对接支付、物流、地图这类重复活,把接口约定、失败案例、代码位置写进仓库文档,或写进内部助手能搜到的上下文。目标是让第二个同类项目按周计,而不是再走一遍 8 个月。
-
按任务分档选模型。 写代码、改架构:用最强的,因为漏测比 token 贵。搜索、分类、高频短请求:用小而快的,并拿真实流量抽样评测。不要全公司一个旗舰模型打天下。
-
AI 提交必须能讲解。 Review 时让作者(或你自己)用自己的话讲:改了哪条路径、测了什么、失败会怎样。讲不清就不当作已交付。
关键图表
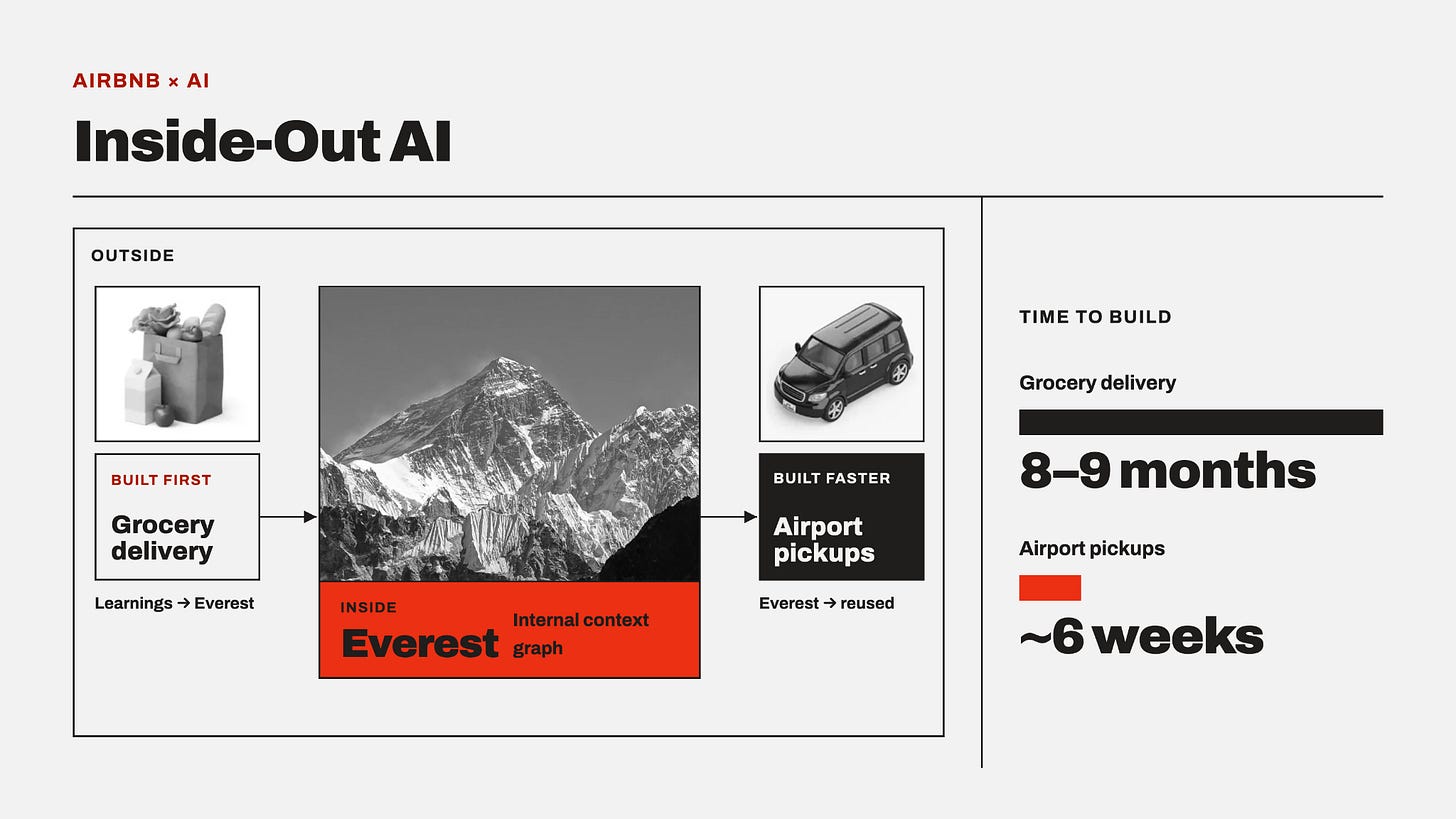 Latent Space 原文图:外部先做杂货配送(8–9 个月),内部上下文图谱 Everest 复用经验后,接机约 6 周上线