LangChain:用 Jev + LangGraph 搭生产 Agent——代码管流程,模型只管窄判断
TypeSafe 的 Jev 不写散文,只对一份 state 并行吐出带概率的类型化答案。LangGraph 把这些便宜判断编进可恢复、可人工介入的图:默认走决策模型,例外才上旗舰 LLM。
结论
Sydney Runkle 和 Hunter Lovell 在 Building Prod with Jev and LangGraph 里把 TypeSafe 的口号落到工程上:搭 prod,不当神。 旗舰 LLM 什么模糊活都能干,但每次调用都为「全能」买单,哪怕你只要一个是/否。Jev 是决策模型(TypeSafe 叫 System One):不生成文字,只吃一份 state(当前上下文)和一组问题,返回带类型、带概率的答案,代码直接分支。LangGraph 负责编排这些便宜判断:节点、状态、边写在代码里,失败可从检查点接着跑,需要人拍板就暂停。控制流不进提示词。
要点
-
软件现在有三条路,不是「手写 if」和「全交给 Agent」两极。 传统软件每个分支手写,可审计但死板。Agent 把每一步决策都丢给同一个大模型,控制流跟着提示词走,难测、难追。中间这条叫 AI-powered software:代码保住结构和精确计算,模型只坐在需要语义判断的岔口——意图、相关性、像不像特权文件。Jev 适合当这些岔口上的零件。
-
Jev 从旗舰模型里拆出「判断」这一项,做成便宜到可以连问的原语。 你给 state 和问题,它并行回答。四条生产属性:答案是带概率的类型,代码能稳定分支;同一份 state 一次可问多题;够快,一次运行里可以做很多次判断;System One 按设计对相同输入给稳定答案。LangChain 早期 Jev-as-a-judge 实验里,100 次重复分数几乎不动,比他们测过的任何 LLM 评委稳。TypeSafe 基准称:路由、分类这类窄决策上,最多大约 200 倍更快、400 倍更便宜——这是供应商数字。
-
判断便宜之后,难的是编排。 LangChain 说团队反复撞上两件事:模型要做对下一步,上下文得刚好是「这一步需要的那点信息」;模型驱动的系统还得扛得住失败、允许人介入、每一步可观察。LangGraph 用三件套回答:节点(一段普通代码、一次模型调用、一次工具调用,或整张子图)、状态(节点读写的共享信息)、边(下一步走哪,可按状态动态选)。小图可以嵌进大图。领域知识写在图的拓扑里:先问什么、后问什么、每题看见哪一段 state——而不是全塞进提示词。
-
运行时把「能上生产」的保证给每个节点,包括 Jev。 模型步骤本身不确定:同一输入可能走出不同路径,失败后从头再跑,不一定走回原路。检查点每步落盘,挂了从已做完的判断接着跑。需要人看一眼再动手,用 interrupt 暂停、批准、再续。每步在 LangSmith 里留轨迹。Jev 吃的仍是非结构化文本,吐的是判断,所以同样需要这些保证。
-
诉讼文件审阅是「同一套窄判断重复几十万次」的例子。 每一页一次请求问三题,答案映射到图上的路由:这份材料响不响应请求?不响应就搁置。有没有个人信息?有就交给 LLM 打码。像不像特权文件(律师往来、法律意见)?像就进
attorney_review,图暂停等人。其余才能交出。作者用同一张图对照:分类步上 Jev 比 Sonnet 快 5–6 倍;LangSmith 里能打开任意一页,看到它走了哪条路、背后的概率。 -
下一步是「智能解绑」,不是再请一个更大的神。 Jaya Gupta 说的 Great Unbundling of Intelligence:把能力拆开,每一步交给能胜任的最便宜模型。Browserbase 按这个思路重做了 Stagehand 的
act():页面上可点的元素是有限清单,Jev 选动作类型和最佳元素,置信度低于 0.7 才回退 LLM。早期测试里,act()中位延迟从 1.97 秒降到 0.46 秒,大约 4.3 倍。默认走便宜模型,例外才上旗舰——不是反过来。
怎么做
面向已经会写一点 Python、听过 LangGraph「节点 / 状态 / 边」的 junior。目标不是再包一层 chatbot,而是把「窄判断」从生成里拆出来。官方可跑的例子在作者的 document review gist。
-
先列步骤,标出哪些是判断、哪些是生成。 路由、分类、要不要升级给人,是判断,给 Jev。改写、打码、解释原因,仍走 LLM。原文的审阅流水线:Jev 做全部分类,只有打码和律师拍板才升级。
-
把流程写成图,不要写进提示词。 一张页子图:
classify→ 按答案走withhold/redact/produce/attorney_review。一批页用Send()扇出,每页一份子图实例、并行分类。attorney_review是唯一会interrupt()挂起的节点。领域规则(先特权、再相关性、再 PII)写在路由函数里。 -
一次请求问完这一页需要的题,state 只放事实。 审阅协议和页文本进 state;标准写在问题上。原文三题:响不响应(有序量表)、像不像特权(是/否)、有没有个人信息(是/否)。答案本身是类型化数据,路由是普通
if,不必先解析一段模型散文。 -
用代码读概率和分数,注意
Score.score是期望值,不是档位。 gist 里的坑:score == 0几乎永不触发,非响应页会被静默放行。他们改成按区间读:低于 0.5 明确不响应,高于 1.5 明确响应,中间才含糊。特权误交出去比多问律师一次贵得多,所以特权升级门槛刻意压低(示例是 0.2)。confidence 量的是分布尖不尖,不是对不对:一页卡在两档之间,即使模型很清楚「和本案有关」,confidence 也会低。只在已经进入含糊区间时才用 confidence 把关,不要一低就全送人。门槛按模型重标,不能从 Jev 抄到另一个引擎。 -
升级时少带机密。 打码节点才调用生成模型,提示要求用
[REDACTED]替换个人信息、其余原文不动。interrupt的载荷只带文档 ID 和分数,不带页原文——中断值会写进检查点,特权内容不要跟着持久化。 -
同一张图换分类器,用轨迹对数字。 分类器做成可注入的
Runnable,图、阈值、中断、汇总字节级相同,只换谁答题。对照跑完,在 LangSmith 里打开任意一页:走了哪条边、概率是多少。再对照 Building a harness with Jev 看路由和自动模式分类器怎么进 Agent 套件。langchain-typesafe仍是 alpha,API 可能变,先在合成语料上跑通再碰真文件。
关键图表
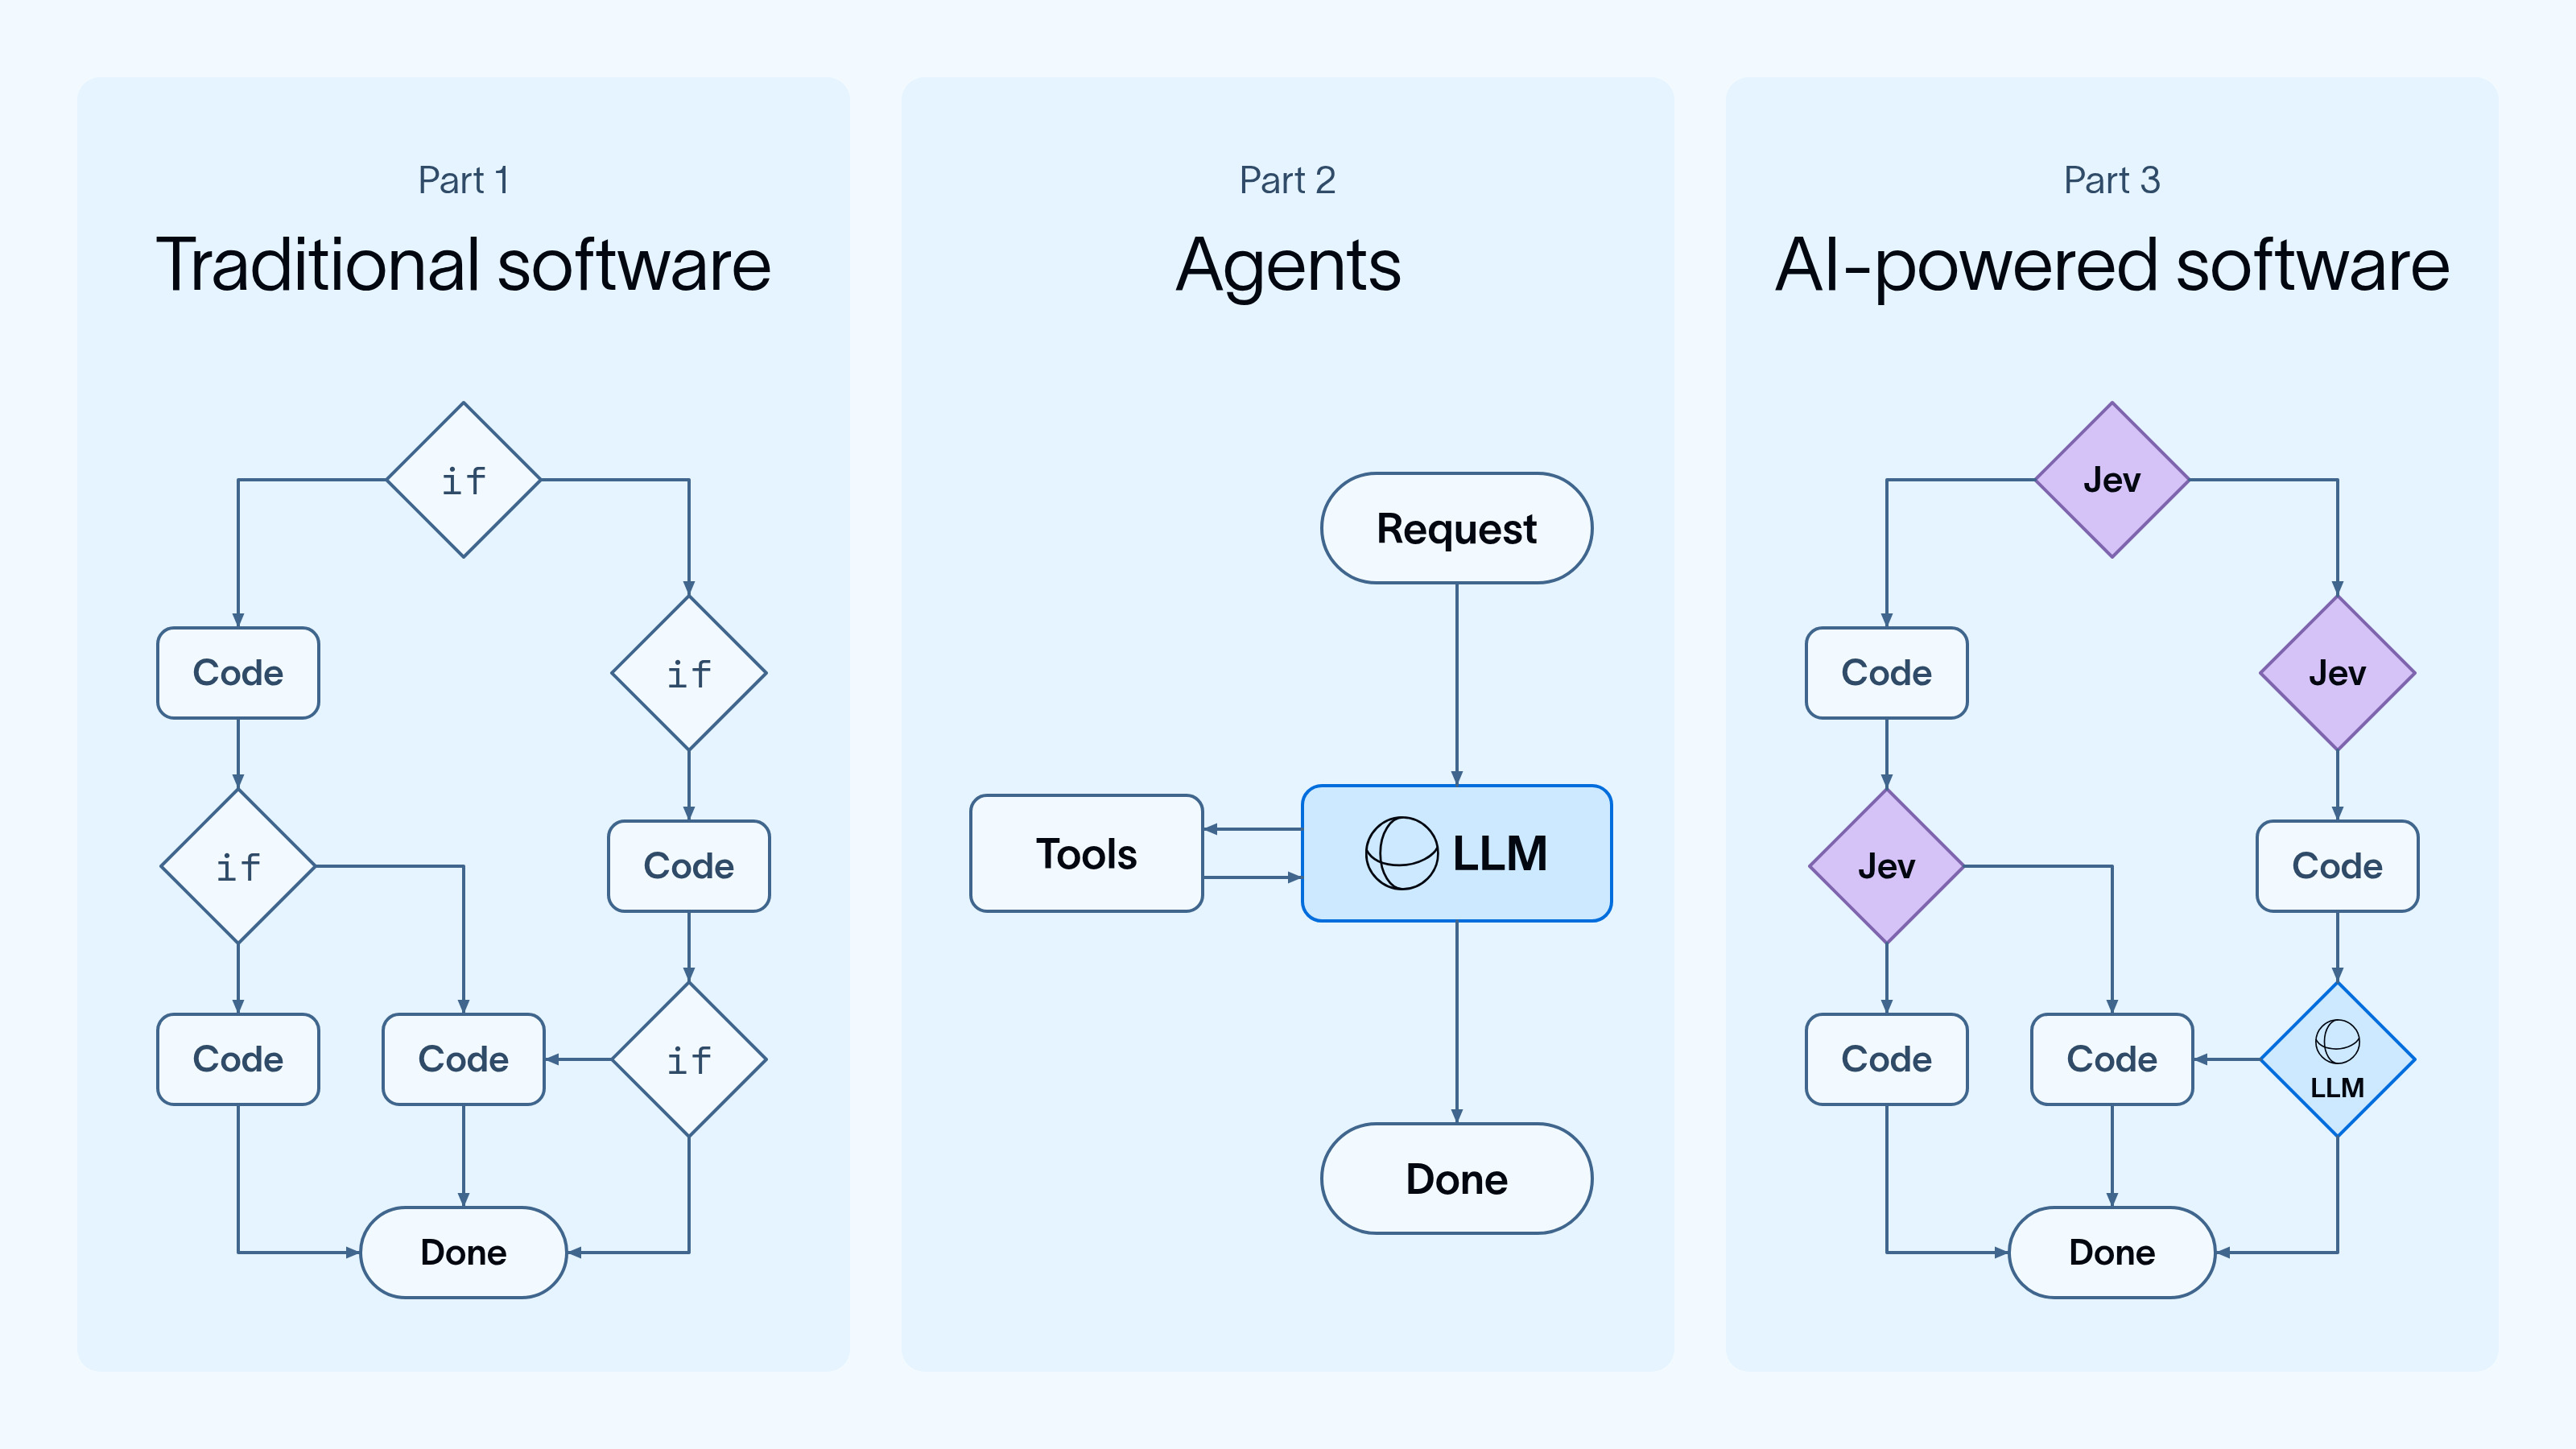 LangChain 原文:左是传统软件(每个 if 手写),中是 Agent(LLM 坐在中间调度工具),右是 AI-powered software——代码保住结构,Jev 坐在需要语义判断的紫色岔口,LLM 只处理开放生成