Cursor:长 Agent 跑次的 token 账——套件五层改完,用户成本降 7%
Agent 跑得更长之后,钱花在每轮都带着走的上下文。Cursor 砍系统提示、按需加载工具、稳住缓存前缀,用户 token 成本降 7%,质量没掉。
结论
Cursor 在 Improved token efficiency for longer agent runs 里判断:Agent 能做更长的活之后,账单从「单次生成」转到「每轮都带着走的上下文」。 套件(harness,包着模型、工具和循环、负责拼请求的那一层)能直接控制三件事:这一轮请求怎么组装、上下文怎么复用、活什么时候拆给子 Agent。他们在这三层上改了几个月,用户 token 成本降了 7%,Agent 质量没有掉。 对 junior 更有用的不是再换一个更便宜的模型,而是先看:系统提示、工具定义、缓存前缀、读文件的行号、子 Agent 分工,有没有在每一步被重复计费。
要点
-
花费结构变了,瓶颈在套件,不在「再下一个模型」。 Agent 现在跑得更久,上一步读到的文件、工具结果和对话,会带到下一步。每一轮都要把系统提示、工具定义、环境和到目前为止的对话再发一遍。套件决定这些东西怎么排、哪些能缓存、哪些可以晚点再加载。Cursor 说这是他们能完全控制、也最该下手的花费。
-
系统提示砍了大约 66%:模型变强后,禁令清单变成噪音。 模型弱的时候,套件必须写清怎么用工具、怎么管理任务、怎么改代码,还要防超长 hash、二进制输出、乱插 emoji。模型强了之后,长篇
DO NOT/You must/Important大多没必要——说清工具做什么,模型一般会照做,而且跨模型家族都成立。新模型仍会带来新指令,再流进下一轮训练;要不要加回去,他们靠真实流量的 A/B 测试,不单靠评测集。评测集常常是「难题」,不能代表用户真实请求的分布。 -
多数工具用在不到 20% 的对话里,不必每轮都带全文定义。 今年套件加了后台 shell 监控、云端子 Agent、更稳的网页读取,工具定义跟着膨胀。Cursor 年初已经把 MCP(Model Context Protocol,模型上下文协议)工具改成动态上下文:需要时再加载,调用过 MCP 的会话总 token 降了 46.9%。同一手法现在用到内置工具。静态上下文只留高频的读、搜、改、shell;另外留下
ask_question(有的模型看不见定义就会幻觉调用)和 Plan Mode 里的create_plan。其余按需加载。A/B 看 token、成本、延迟、工具调用错误和整体用量,确认省钱没有掉质量。静态上下文里的工具描述 token 因此少了 60%。 -
缓存要命中,前缀必须稳。 每一轮都重发一长串请求:工具、系统指令、setup、对话。开头几层往往没变,尾巴上的对话在涨。Prompt caching(提示缓存:供应商复用没变过的前缀,少算一遍)能不能省钱,取决于你有没有把「很少变」和「每轮都变」切开。GPT-5.6 之前,缓存边界多半由供应商按最新请求自动猜;工具和系统指令虽然几乎不变,也没有被单独标成可复用。GPT-5.6 起,OpenAI API 允许客户端在默认隐式缓存之外,自己标 cache breakpoint(缓存断点:告诉供应商「到这里为止可以当稳定前缀」)。Cursor 把断点放在稳定层之后、增长的对话之前;skills、子 Agent、环境信息这类会变的 setup,挪到断点后面的 phantom user message(幽灵用户消息:看起来像用户消息、其实是套件塞的会话级上下文)。冷缓存未命中降了 20%。
-
读文件的行号,积少成多。 Agent 用
Read读代码。模型不善数行,引用给用户时又需要行号,所以以前每一行都标号,一行大约 3–5 个 token。一次会话读几万行,行号本身就是一笔上下文。现在只在每第十行标号,模型仍能引用代码,cache-read token 降了 1.6%,质量没有掉。 -
子 Agent 能省父上下文,但有协调税。 子 Agent 通常从空窗口开工,回报结果后,父 Agent 不必带着它的全部中间过程。两边不共享上下文时,也会重复劳动,或去做已经过时的任务。Cursor 做了两处收:第一,删掉「探索代码库请尽量用子 Agent」的强提示——训练数据里已经常见,模型自己会,再催反而用过头;第二,收紧换模型的参数,只有用户或套件指定时,子 Agent 才换模型,避免为了补盲区或「规划用贵模型、实现用便宜模型」而默认乱切,把缓存和分工一起打乱。
怎么做
面向已经在用 Cursor Agent、或自己拼 Agent 套件、却觉得「模型越用越贵」的工程师:
-
先分清「模型账单」和「套件账单」。 打开一轮长任务,问:系统提示、全部工具定义、skills、环境信息,是不是每一跳都原样重发?能砍的是套件,不是再换一个更便宜的旗舰模型。
-
系统提示写行为,不写禁令清单。 工具说明写成「它读什么、返回什么、失败时怎样」,少写
DO NOT。新模型如果又出现一种怪癖,再加一条,并用真实流量 A/B,不要只拿难题评测集当依据。 -
工具定义按调用频率分层。 读、搜、改、shell 这类几乎每轮都用的,可以留在静态上下文。MCP 工具、后台监控、网页读取、云端子 Agent 这类低于两成对话才用的,做成按需加载。某工具看不见定义就会被幻觉调用(原文的
ask_question),就不要动态卸掉。 -
把很少变的东西放在请求最前面,并且别改它的字节。 工具定义和系统指令一旦稳定,就固定顺序、固定措辞。会话级的 skills、子 Agent 列表、机器环境,放到缓存断点后面。前缀里插一句「今天的目录是……」,整段缓存都会冷掉。
-
读代码时别默认「每一行都带行号」。 自建
Read工具可以每 10 行标一次,或只在模型要引用的窗口里标号。一次会话读几万行时,行号本身就是 cache-read。 -
子 Agent 用来隔离上下文,不用来「显得更 agentic」。 探索仓库、跑一段调查,适合新窗口;父任务还要把结论接回去时,写清回报格式,避免两边各干各的。换模型只在你明确要「规划用贵的、执行用便宜的」时再开,不要让模型自己挑。
-
用真实请求分布验收,不要只看难题评测。 Cursor 同时看 token、成本、延迟、工具错误和用户是否还在用 Agent。省了 7% 但错误率抬头、或用户不再把长任务交给 Agent,就不算成功。
关键图表
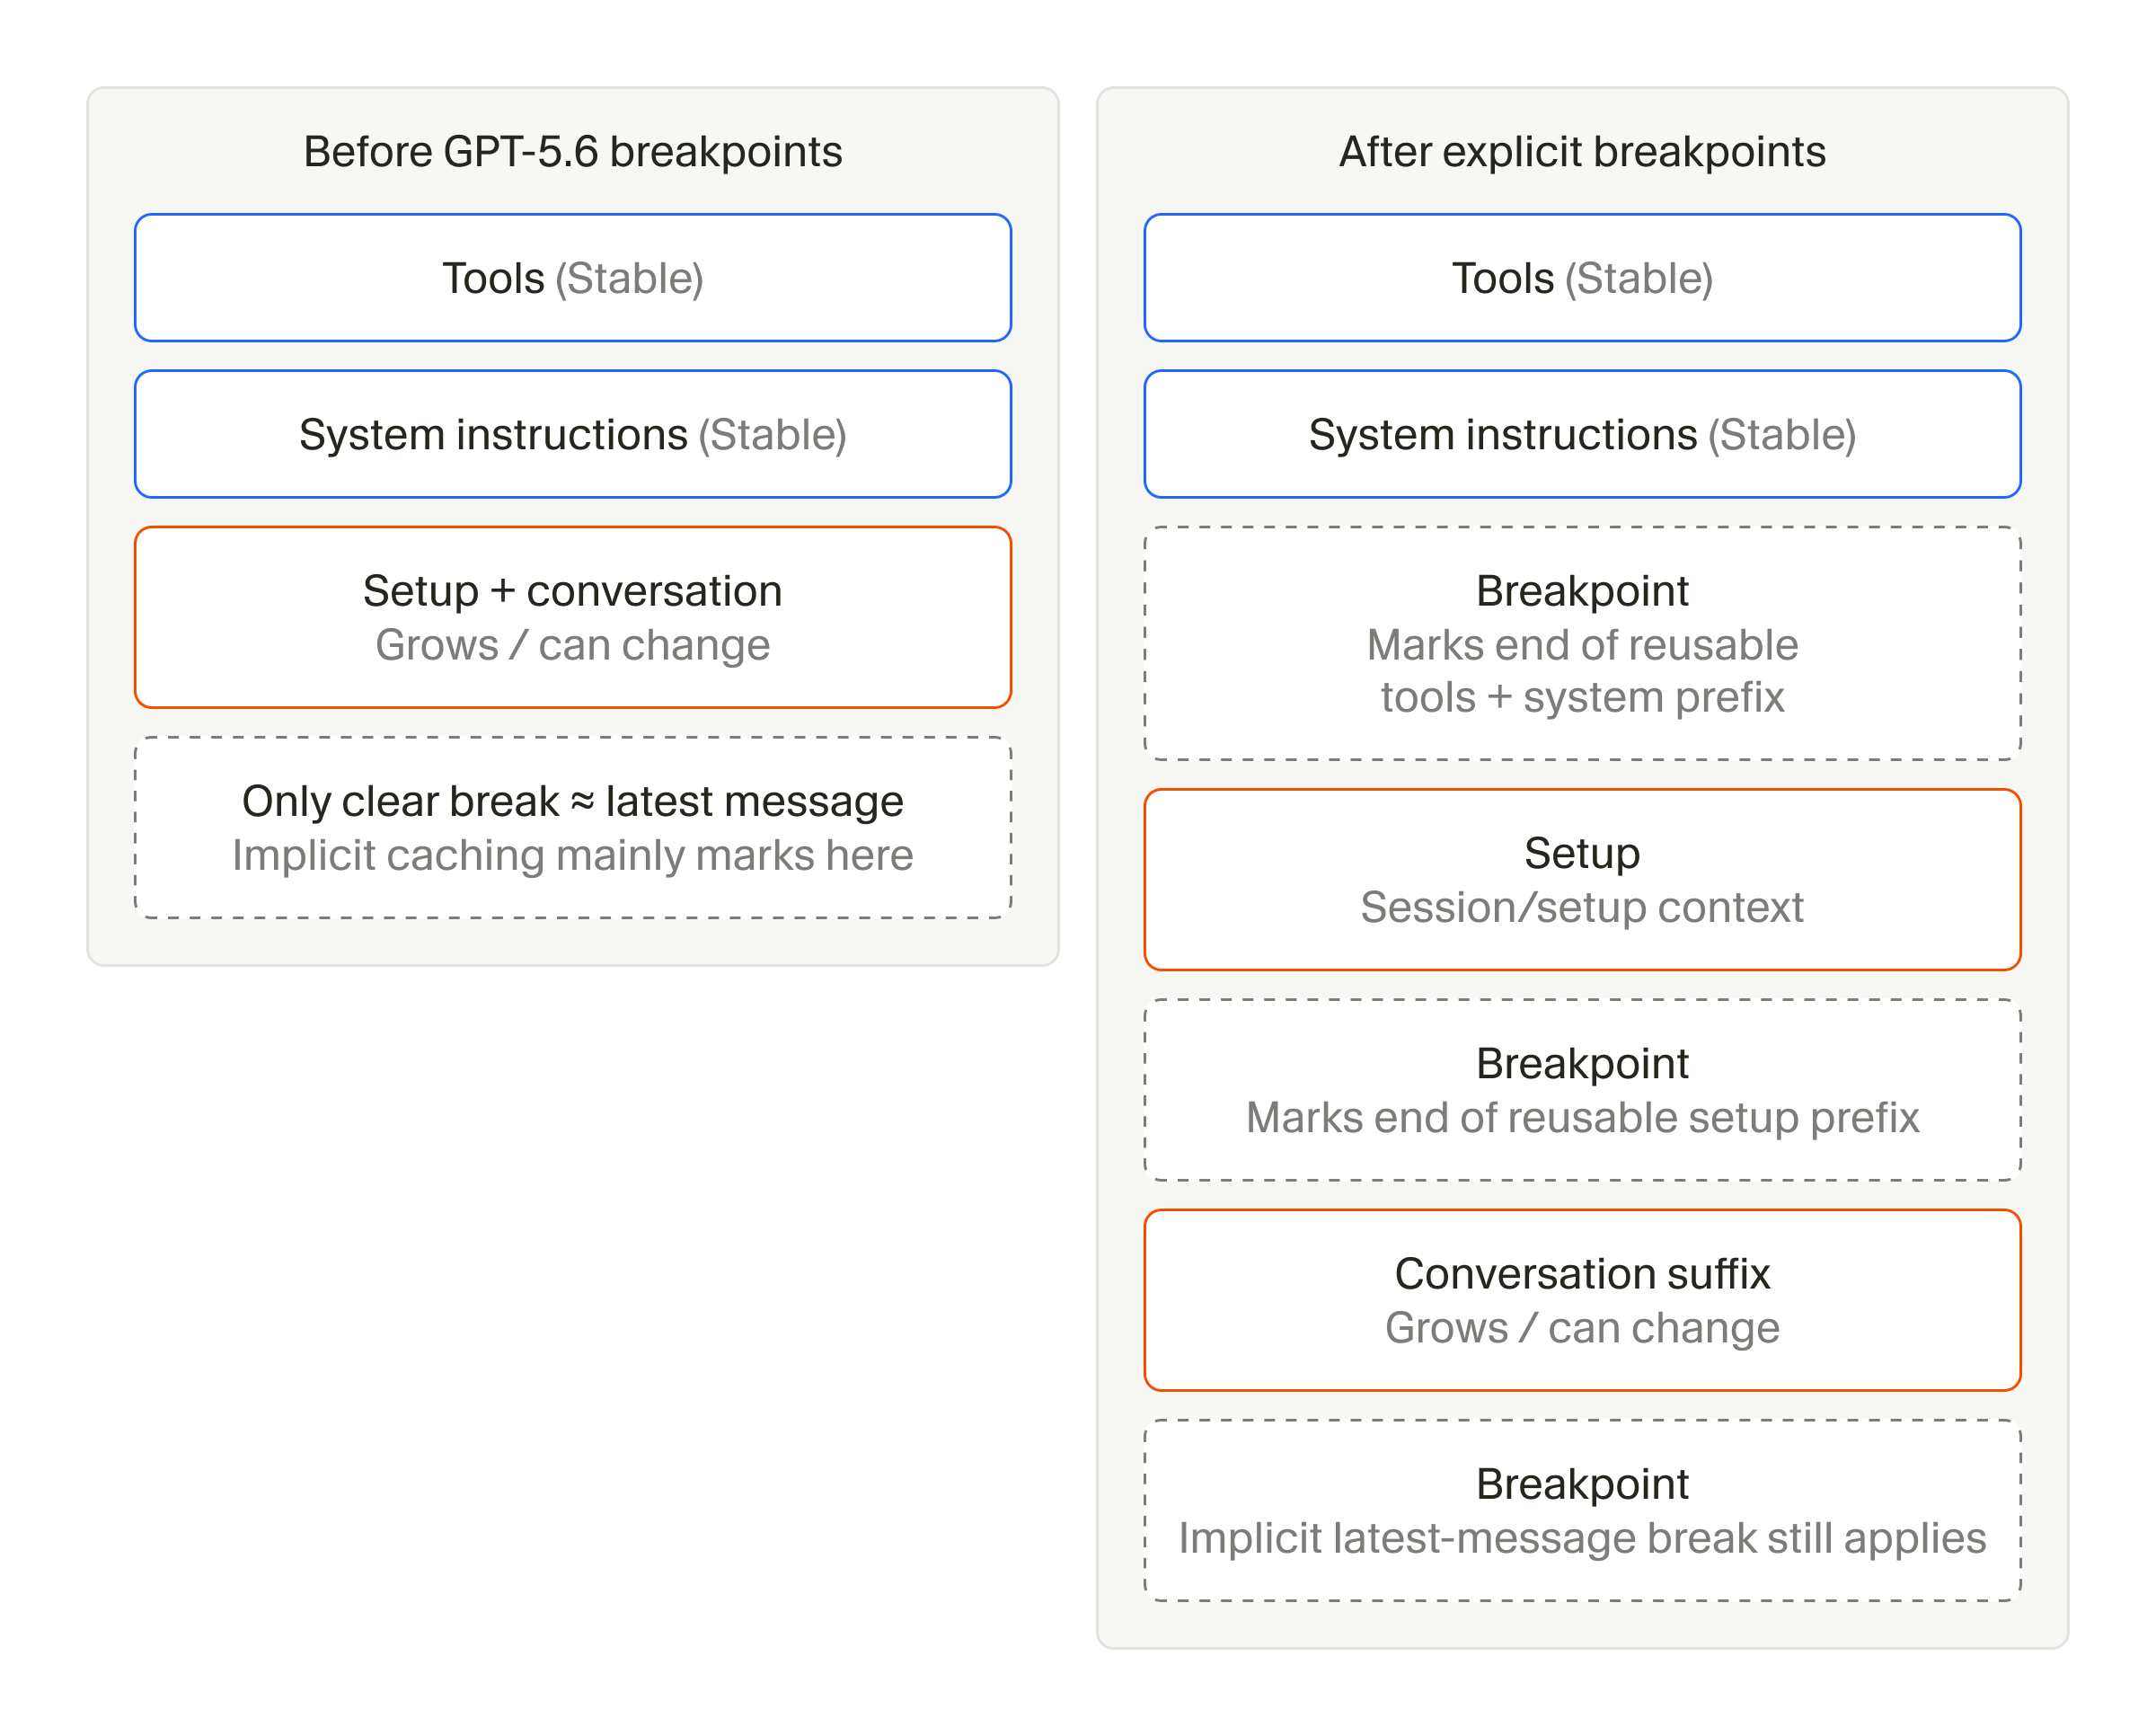 Cursor 原文:左边是 GPT-5.6 之前,工具和系统指令虽然稳定,却和会变的 setup、对话混在一起,只能靠隐式缓存在最新消息附近碰运气;右边在稳定层之后、增长的对话之前打断点,冷缓存未命中降 20%