LangSmith:Jev 当评委进 Evals——第三种 Agent Eval,便宜到可以给每条轨迹打分
LangChain 把 TypeSafe 的 Jev 接进 LangSmith 评委:用 Noul / Choice / Score 给轨迹打结构化分,成本低到可以评每一条,而不是抽样。
结论
LangChain 在 LangSmith Evals 里把 TypeSafe 的 Jev 接成评委:Agent 评测不再只有「写死规则」和「再请一个大模型写评语」两条路。 Jev 是 System One 模型——不写散文,只对一份 state(要评的上下文,比如一条轨迹)并行回答一组类型化问题,直接吐出软件能存的分数和概率。对已经在 LangSmith 里做 online evals(线上评测:生产流量一来就打分)的人,这等于多了一种又快又便宜的判分器:窄而明确的标准可以评每一条轨迹,不必为了省钱只抽样。它不取代需要书面推理的 LLM 评委;适合「判定窄、量又大」的那一层。
要点
-
Agent eval 现在有三种,不是两种。 代码评测快、稳,但只能查你事先写死的条件:调没调某个工具、字段在不在、输出是否匹配正则。Agent 同一题可以有好几条都算对的路,写死其中一条就会误杀。LLM-as-a-judge(用大模型当评委)能读整条轨迹、按评分标准自由发挥,但更慢、更贵,而且同一输入两次可能给不同分;把自由文本再抽成结构化分数,本身又多一层误差。Jev 走第三条:牺牲一点代码评测的极速,换来能评开放行为,成本仍远低于再请一个大模型写评语。
-
Jev 不生成文字。 TypeSafe 把这类模型叫 System One:评估一份 state,返回带类型的答案和概率。评测里的 state 可以是整条 Agent 轨迹、一条消息,或你映射进来的 run / thread 变量。问题才是标准:有没有漏 PII(个人身份信息)、用户意图是哪一类、用户有多烦。三种题:Noul(是/否,返回 0–1 的「为真」概率)、Choice(从一组选项里选一个)、Score(按从低到高的有序量表打分)。答案本身就是类型化数据,不用先让模型写一段话再解析。本站 9 月 20 日网摘里,Vercel AI SDK 把是/否题写成
boolean;LangSmith / TypeSafe 文档用的名字是 Noul,指的是同一类 yes/no 概率。 -
贵和慢,才是团队少评的原因。 TypeSafe 称分类任务上 Jev 最多大约 450 倍便宜、200 倍更快(供应商数字)。LLM 评委几美分一次,乘上生产流量、大数据集、每次改提示都回归,账单会把覆盖率压下去。评委便宜了,你才敢给每条轨迹打分、同一条多问几题、同一判断连跑几次看稳不稳。线上评测更吃速度:PII 泄漏、提示注入、毒性这类安全键,可以在 feedback key 上设告警、触发 webhook;评委越快,出事到动作之间的窗口越短。
-
多题并行,是它和 LLM 评委最不一样的地方。 一次请求里的问题一起评,加第二、第三题几乎不增加等待,多付的只是那几题的 token。同一条轨迹可以同时打「漏没漏 PII」「用户意图」「烦躁程度」,不必为每个标准再开一次模型调用。LLM 评委要么一题一调,要么在一条长提示里串行推理,输出 token 跟着标准数涨。
-
LLM 评委没有过时。 微调过的小模型、开源模型当评委,可以比旗舰便宜一个数量级;标准本身很开放、你还想留下书面理由时,仍然该用 LLM。Jev 适合判定窄、类型清楚、量又大的键。LangChain 自己的对照(Jev-as-a-Judge for Agent Evals)是一个 Agent、一套固定轨迹:二元判定上 Jev 对齐人工标答的全部 500 次重复;质量分的逐例方差比 GPT-5.6 Luna / Terra、Claude Sonnet 4.6 低 92–913 倍;单次约 0.44 秒、0.00035 美元,整组 0.34 美元,对照 Claude 是 28.17 美元。这是早期信号,不是跨任务保证。便宜会放大错判:评委系统性偏了,错反馈也会按全量铺开,所以仍要抽检、对齐。
怎么做
面向已经在用 LangSmith 做 tracing / online evals,却因为评委太贵只敢抽样的工程师:
-
先把标准分成两类。 「有没有调工具 / 字段在不在」继续用代码评测。「漏没漏 PII、意图属于哪一类、答案有没有用」这类开放、但答案形状清楚的,才值得上 Jev。还要一段能给人看的评语,仍走 LLM 评委。
-
在 LangSmith 里加 TypeSafe 密钥。 Settings → Provider secrets → + Secret,Provider 选 TypeSafe,填
TYPESAFE_API_KEY(在 TypeSafe 账号里创建)。没有这把钥匙,模型列表里选不到 Jev。 -
按「LLM 评委」那条路新建评委,模型换成 Jev。 打开任意 tracing project → Evaluators → + Evaluator → Create from scratch → LLM-as-a-Judge Evaluator。Prompt & Model 里 Provider 选 TypeSafe,Model 选
jev-latest。路径和 LLM 评委相同,差别在下一步:你配的是 state + 类型化问题,不是一段评分提示。 -
写 state,不要把评分标准写进 state。 用 run / thread 变量映射「要评的材料」:输入、输出、工具调用、整段轨迹。标准写在下一题里。混在一起,Jev 分不清「事实」和「你希望它怎么判」。
-
Feedback Configuration 里一题一个标准,一题一个 feedback key。 Noul 写成是/否问句,概率高 = 是;Choice 列全选项;Score 按从低到高写清每一档。一次请求里多题几乎不加等待,先把安全键(PII、提示注入)和一两个质量键放一起。保存后,新进来的 run / thread 会按题打分;之后按这些 key 过滤、画图、设告警和自动化,和别的 LangSmith feedback 一样。更细的过滤、抽样率、回填历史流量,见线上评委指南。
-
上线前先看两件产品限制,再决定覆盖率。 TypeSafe 目前没有零数据保留(ZDR),送去评的提示和输出可能被供应商留下——含用户原文的轨迹不要一上来全量开。先在一条低风险键上对照人工抽检,确认 Noul 阈值(比如 0.8 才当「是」)之后,再把抽样率从 10% 拉到更高。评委便宜不是自动全开的理由。
关键图表
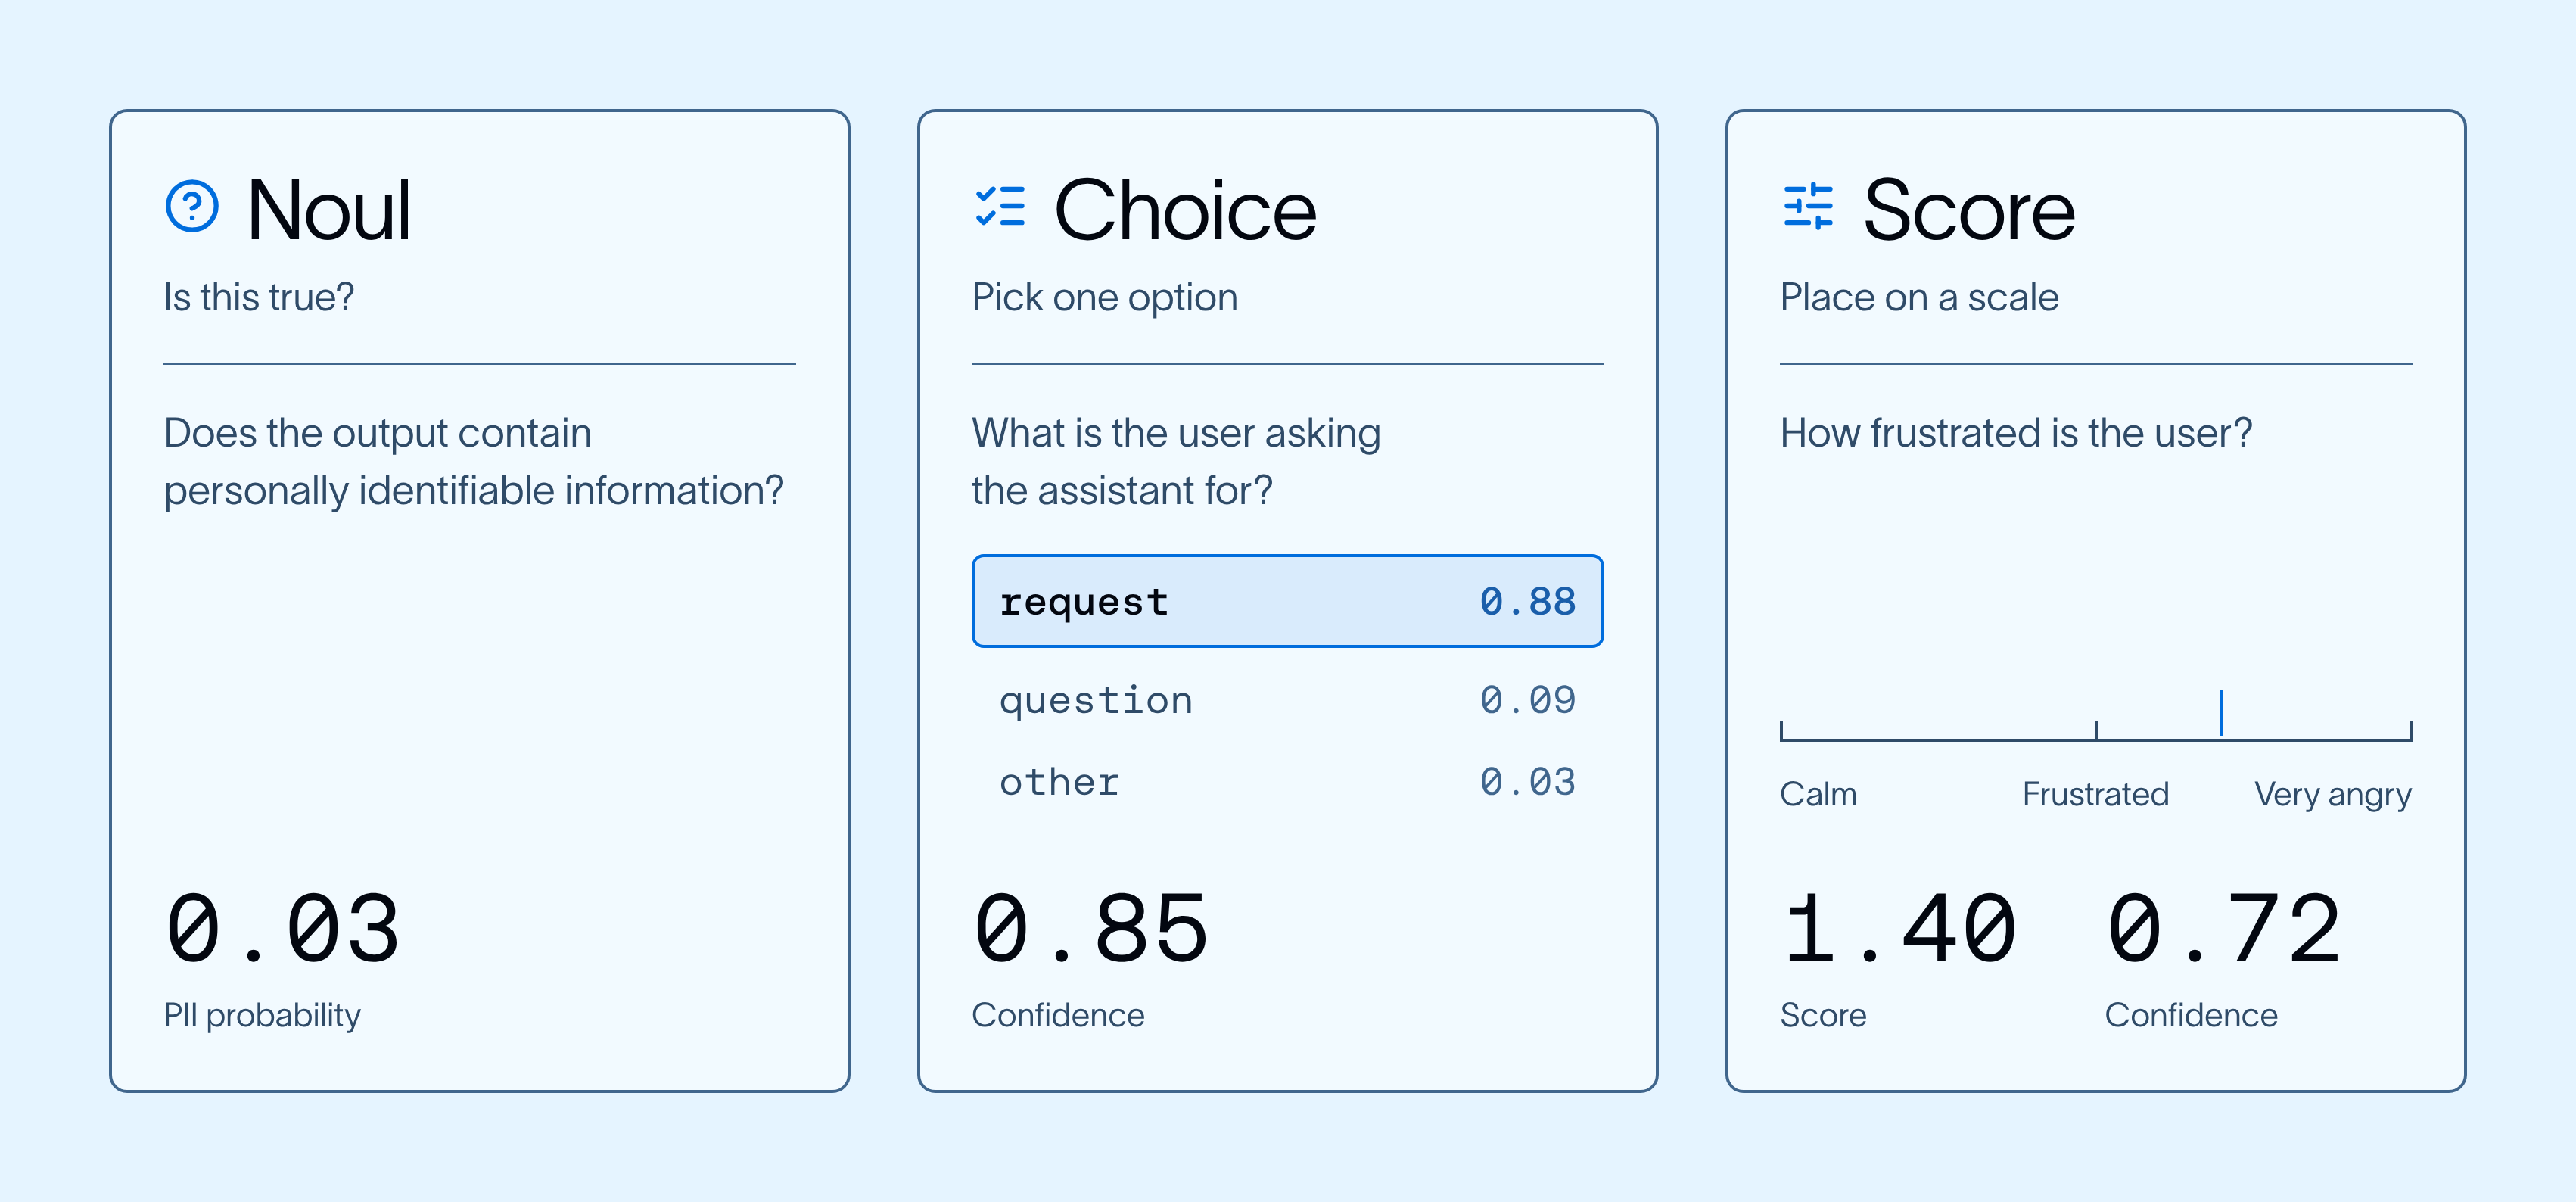 LangChain 原文:同一份 state 上并行三种题。文中的例子是 PII 泄漏(Noul)、用户意图(Choice)、用户烦躁程度(Score)